
TP官方网站下载怎么实现自动化 从配置到跑通实操拆解
TP官网的下载链路说白了就三步:触发鉴权、定位资源、拉取文件。手动点一次不碍事,但每天重复几十次,人一直盯着屏幕操作太浪费了。把这条链路交给脚本自动跑,效率提升是质变级别的TP官方网站下载怎么实现自动化 从配置到跑通实操拆解,从人力操作变成零介入。
鉴权是最大卡点。TP官网下载接口依赖session token,有效期有限,过期必须重新获取。实操中我用Python的requests库维护一个token池如何在TP官方网站下载中实现自动化流程,每次请求前校验剩余有效期,低于阈值就自动刷新,防止token过期把整条流水线打断。
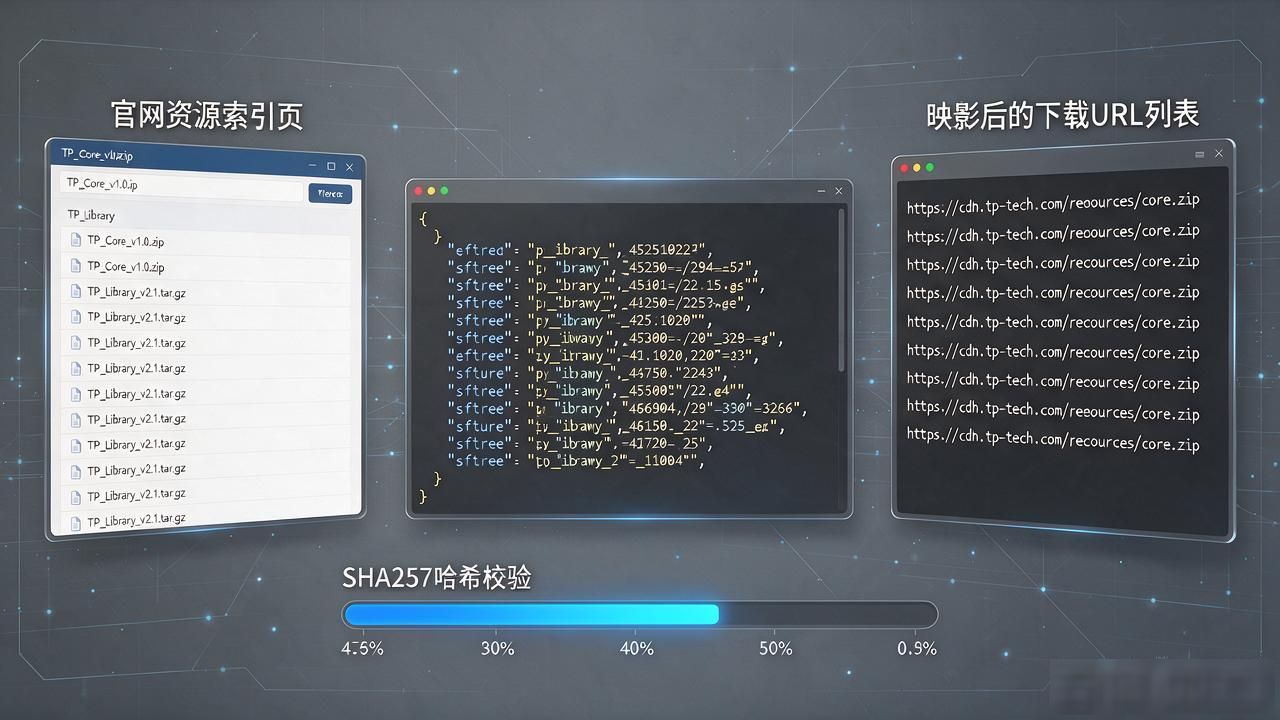
批量拉取环节,关键是把文件清单和下载URL做映射。一般从官网资源索引页解析出全量链接,存成JSON,脚本按清单顺序逐个拉取,下完校验SHA256哈希值,不一致就自动重试,把出错率压到接近��。
调度这块交给cron或者CI/CD的定时触发器,每天凌晨固定跑一轮,跑完把新文件推到内网对象存储。失败告警直接接企业微信机器人,半夜出了问题手机就能收到通知,不用人肉翻日志排查。
手头如果也有一批固定资源要从TP官网定期同步,把token刷新策略和哈希校验逻辑先写扎实,整套流程搭下来基本一个下午就能跑通,后续就彻底省心了。
